怎么看待 OpenAI 发布的 AI 水印技术?
从 textGrain 的机制、误报率和写作情景出发,理解 AI 文本水印的检测结果,以及我们如何评价 AI 参与的作品。
2026 年 10 月 5 日,OpenAI 发布了文本水印方案 textGrain 的官方说明[1]与技术报告[2]。这项技术会在部分模型生成的文字中嵌入不可见的统计信号,为后续识别 AI 的参与提供线索。
这个“水印”是怎么加进文字里的,又会带来什么样的影响?当一段文字被检测出 AI 水印,究竟意味着什么?
一、文字中的水印是什么?
1. textGrain 的基本机制
文字不是图片,没有像素,水印会藏在哪里?
模型每往下写一步,都要从候选词或词片段(token)中作出选择。它会根据前文,给这些候选分配不同的概率,再按概率抽样,决定接下来写什么。
textGrain 就在这一步介入。它利用密钥和附近的前文生成规则,将候选词分组,调整选中各组的概率,再在选中的组内按原有的相对概率选词。这样,模型选出的词就与密钥产生的规则建立了统计关联。水印藏在这些选择里。
但选词越受水印规则支配,模型原本的抽样随机性也会减少。textGrain 为此设置了“熵损失预算”:用熵衡量生成时的随机性,再以原有熵的一定比例为预算,控制水印所消耗的随机性。算法要在留下可检测信号的同时,为生成不同的表达保留余地。
检测时,检测器拿到文字,用同样的密钥和每个位置附近的前文重建规则,计算实际选词与规则的对应关系,再把各个位置的评分汇总,判断整段文字是否呈现出水印的统计特征。[2]
文本长度与语境约束也会影响检测效果。在官方报告给出的测试中,将目标误报率设定在 1% 时,心理学等内容约 200 token 时检出率约为 80%,400 token 时可达约 95%(这里的 token 并不等同于汉字字数);而在约束较强的数学类内容中,由于概率分布往往更为集中,检出率会有所下降。[1]
改动文字也可能削弱已有信号。在官方报告的一项实验中,将 400 token 英文文本中 10% 的词替换为同义词,检出率由约 92% 降至 66%;替换 25% 时降至 17%。[1]
按照此次公布的安排,部分模型的 API 用户可以自行开启水印,默认关闭;在欧盟地区,符合条件的 ChatGPT 与 Codex 输出将在随后数周内逐步加入水印。配套检测工具首期向获批的研究人员与专业机构开放。[1]
2. 怎么看检测指标:“1% 误报率”不等于“检出就有 99% 的把握”
关键要看,这个百分比的分母是什么。
不妨做一个假设:
- 假设有 10,000 篇被检测文本,其中 100 篇带有水印,其余 9,900 篇不带水印。
- 假设检出率为 95%,那么 100 篇带水印文本中会有约 95 篇被检出。
- 假设误报率为 1%,那么 9,900 篇不带水印文本中会有约 99 篇被误报。
- 最终被标记为阳性的文本共有 95 + 99 = 194 篇。在这些被标记的文本中,真正带有水印的比例约为 95 ÷ (95 + 99) ≈ 49%。
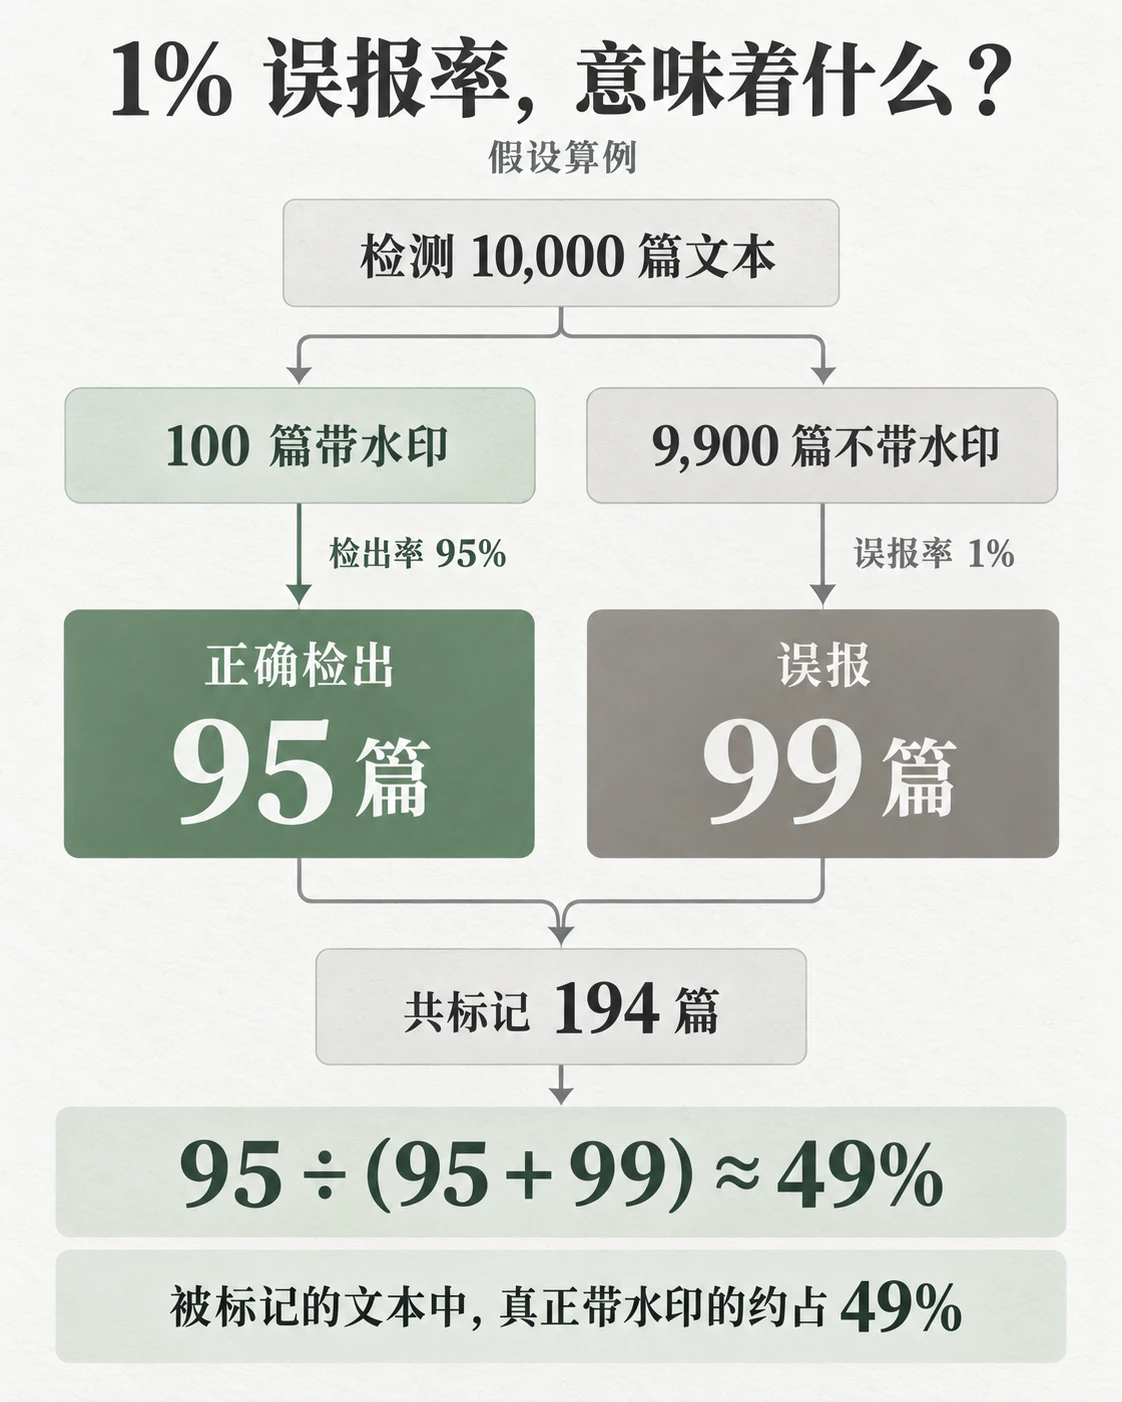
误报率回答的是:不带水印的文本里,有多少被认错了?拿到一份检测结果时,我们问的却是:被标记的文本里,有多少真的带水印?如果不带水印的文本远多于带水印的文本,哪怕只有 1% 被认错,误报数量也可能超过真正检出的数量。上面的例子中,误报的 99 篇,甚至比正确检出的 95 篇还多。
所以,误报率再低,也要结合被检测材料中带水印文本的实际比例,才能判断一次检出有多可信。
3. 水印检测与“AI 率”的区别
textGrain 寻找的是生成时预先留下的信号。常见的“AI 率”检测,则是根据语言特征判断一段文字有多像 AI 写的,两者的方法不同。没有检测到水印,也不能证明文字由人独立写作。
水印强弱无法直接换算成 AI 写了多少。但这项技术让一个问题变得更具体了:当一篇文章被标记为“有 AI 参与”,我们该怎样理解这个结果?
二、做两个情景假设,理解 AI 水印
实际写作往往包含个人要求与多轮修改。这套机制在具体协作中会怎样表现?可以通过两个情景假设来理解。
1. 情景一:逐步加入个人要求
假设我们请 AI 写一段文字,随后逐步加入个人要求:“语气再克制一点”“这里用这个术语”“不要用这种说法”。文字越来越接近我们想要的样子,水印会怎样?
这些要求会改变模型接下来选词的概率。关键要看,它们究竟留下了多少选择余地。“写得克制一点”可以有很多种写法,模型仍能在不同的词句之间选择,水印机制也就仍有发挥作用的空间。提示词写得多细,与模型还剩多少选择空间,是两回事。
拿写诗来做个对照。同样想让 AI 给出一首以思乡为主题的诗,我们可以提出两种要求。
一种是:“帮我写一首思乡的诗。”除此之外不加限制。它可以写月亮,也可以写故乡的街巷;可以用五言,也可以用七言。写什么、怎么写,都还有很多选择,水印机制便有空间在选词时留下信号。
另一种是:“背诵李白的《静夜思》。”这时,它要给出的就是那首熟悉的诗:
床前明月光,疑是地上霜。
举头望明月,低头思故乡。
只看这二十个字,如果要求严格按原文复现,模型每一步都只有一个选择,不能另换一种说法。在这个输出完全固定的情景里,选择空间为零,熵也就为零,无法再通过选词嵌入新的水印信号。
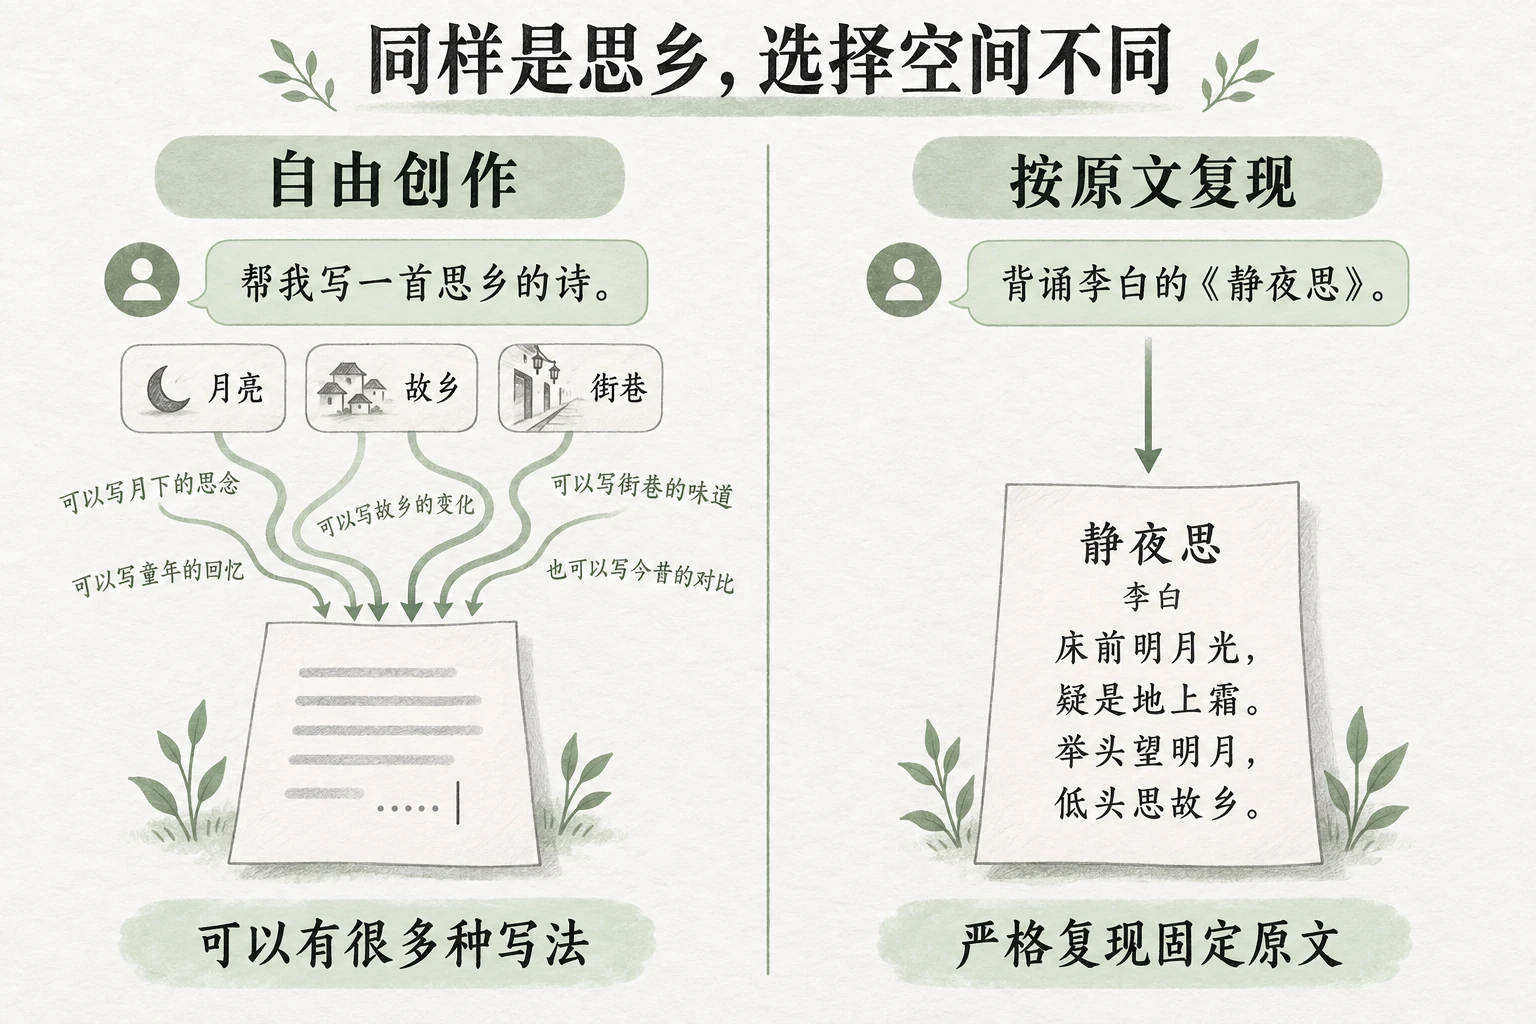
同样是由 AI 输出,自由创作与背诵原文,留给水印的空间就很不一样。关键在于输出时还有多少选择余地。
2. 情景二:经历多轮重写与删改
再想象另一种情景:AI 写出一篇三段的短文,你觉得第二段不满意,让它只重写这一段,再把新版放回文章,第一段和第三段原样保留。这样拼起来的文章,还能检测出水印吗?
按照 OpenAI 技术报告[2]的检测方法,检测器会根据每个词和它前面的一小段上下文计算局部评分,再汇总判断。在密钥和配置不变时,同样的词和局部前文,会得到相同的局部评分。它并不需要知道这段文字来自第几轮生成。
先看第一段。它没有改动,前文也没变,原有的局部评分就能保留。第二段重写了,并不会让第一段的水印跟着消失。
再看新生成的第二段。如果仍由启用水印的模型来写,只要生成时还有选择余地,它就有机会留下新的水印信号。改写并不只是移除旧文字,也是在生成新文字。
第三段稍有不同。它开头的文字虽然没动,但前面接着的第二段变了,部分评分可能受到影响。继续往后,当检测所用的前文已经全部落在未改动的第三段内部,原有的局部评分就能恢复。
这样,最终稿里便可能同时存在保留下来的旧信号和重新生成的新信号。只要这些信号足以达到检出标准,经过多轮修改的文章,依然可以被检测出水印。
三、如果检测出 AI 水印,意味着什么?
我们不妨再往前问一步:即使确切知道一段文字全部由 AI 生成,这又能说明它的正确性和价值吗?
我认为,对创作成果的评价,应当围绕内容本身是否正确、是否有价值展开。AI 是否参与创作,甚至内容是否全部由 AI 生成,都不能直接回答这两个问题。
在与 AI 协作时,如果产出的内容事实准确、表达清晰,也体现了我们认可的判断,就没有必要仅仅为了降低检测分数而再改一遍。
引用需要忠实于原文,术语需要用准。同一个事实可以有不同说法,但为了避开检测,把准确的词换成别扭的同义词,文章并不会因此变好。
空话删掉,错误改正,没说清楚的地方重写,这些修改都有具体的理由。“检测出 AI”本身,不应自动成为一项修改任务。
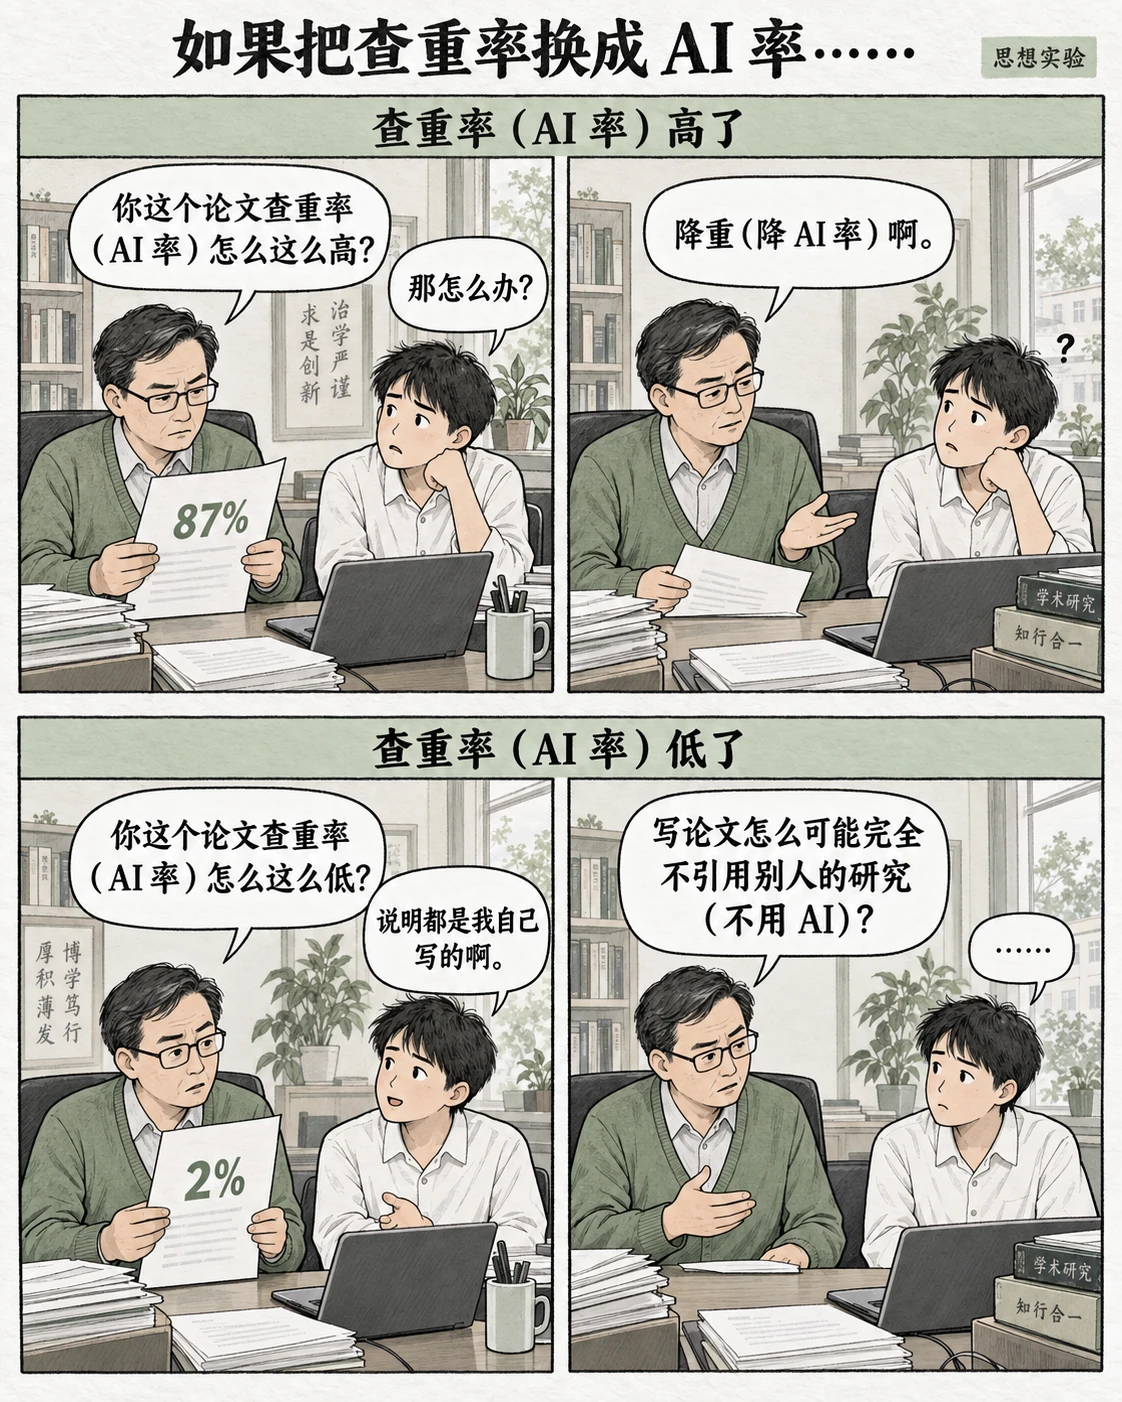
这让我想到了论文查重。想象一下,如果把“查重率”替换成“AI 率”,会出现哪些有趣的画面?
查重率(AI 率)高了:
导师:你这个论文查重率(AI 率)怎么这么高?
我:多少?
导师:87%。
我:啊?查重率(AI 率)还有要求吗?
导师:学校要求控制在 20% 以内。
我:那怎么办?
导师:降重(降 AI 率)啊。
查重率(AI 率)低了:
导师:你这个论文查重率(AI 率)怎么这么低?
我:低还不好吗?
导师:才 2%。
我:说明都是我自己写的啊。
导师:问题就在这儿。
导师:写论文怎么可能完全不引用别人的研究(不用 AI)?
我:……
这项技术会不会被用成类似论文查重的工具,进而让检测分数成为限制创作、限制使用 AI 的考核审查标准,我不好说。但我认为,如果真走到这一步,那也只会是一种短暂、畸形、幽默的使用方式。
当 AI 成为日常研究和创作的一部分,仍将“避免留下 AI 痕迹”作为成果的评判标准之一,就会与正常的工作方式越来越冲突。这也是我认为这种限制难以长久的原因。
资料来源
[1] OpenAI:文本来源与水印发布说明,2026 年 10 月 5 日。
[2] OpenAI:《textGrain: Entropy-Calibrated Watermarking for Language Model Text》,技术报告。
AI 贡献声明
作者提出选题、两个情景问题与师生对话,确定文章结构和核心立场,并逐轮审阅、调整技术解释与中文表达;AI 参与资料核对、大纲梳理、正文起草与修改,以及配图设计和生成。