科研数据集一年暴增 3.9 倍:当知识生产的基础设施开始“为 Agent 而不是为论文排版”
从 Hugging Face 的 Project ProtoStar、MIT 的物理世界模型到麦格劳希尔接入 MCP,知识生产机构正在把核心交付物从“给人读的论文与电子书”,重构成“给模型和 Agent 调用的数据基础设施”。
本文目录
2026 年 10 月底,Hugging Face 联合卡内基梅隆大学(CMU)等高校与研究机构启动了一个名为 Project ProtoStar 的计划。[1]平台披露了一组很容易被当作普通运营数据划过去的数字:截至 2026 年 11 月 11 日,平台上新增的科学数据集达到了 21,000 个——作为对比,2025 年同期这个数字是 4,900 个。哪怕剔除掉平台上的单一最大上传者,真实增速依然高达 3.9 倍。
如果把这组数据和另外两件事放在一起看,事情就不再只是“开源社区变热闹了”:
- 11 月 9 日,MIT 和 UBC 等机构的研究团队公开了名为
WorldParticle的物理世界模型。[2]它不再针对流体、布料或蛋白质分别编写偏微分方程求解器,而是像大语言模型预测下一个词一样,直接从统一粒子的时空数据里学习物质运动的底层动力学。 - 10 月 29 日,老牌教育出版商麦格劳希尔宣布将通过 MCP(模型上下文协议)向微软 Copilot 开放授权教材内容。[4]
一个是公共科研实验室的数据仓库,一个是物理模拟的底层方法,一个是商业教材出版社。它们看似分属不同行业,指向的却是同一个结构性变化:严肃的知识生产机构,正在把自己的核心交付物,从“给人眼阅读排版的文件”,重构成“给模型和 Agent 调用的数据基础设施”。
一、论文是“成品”,数据曾经只是“附录”
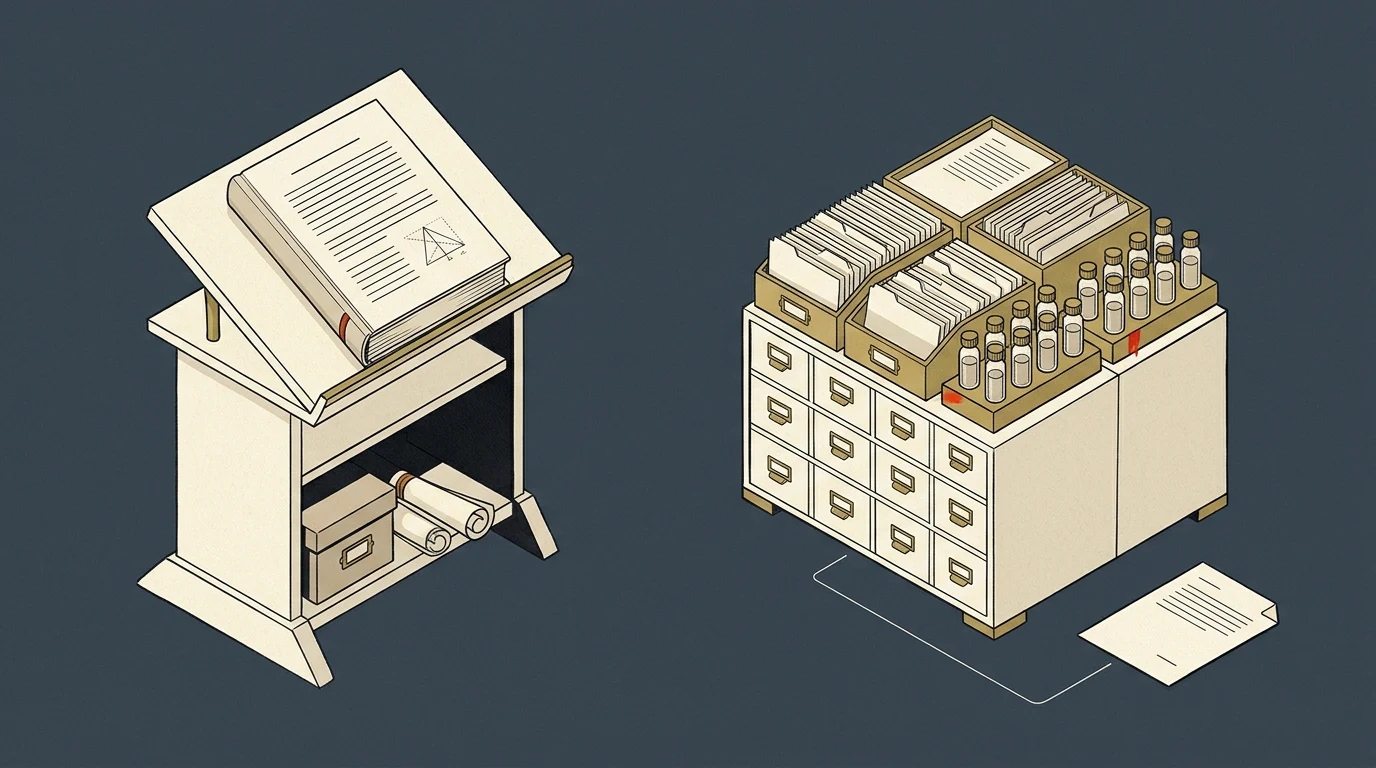
在过去三百多年的现代科学体制里,知识流通的标准介质是论文。
实验室跑完实验、收集完观测记录、算出统计显著性,最后要把这些过程压缩成一篇结构严谨、排版精美的 PDF。在这个体系里,论文是受同行评议认可的“正餐”,而支撑论文的原始数据、清洗脚本和实验日志,往往只是附在文末的一个补充材料链接(Supplementary Materials),甚至长期锁在课题组的本地硬盘里。
这种分工在“人类是唯一读者”的时代完全合理。人的注意力有限,阅读带宽极窄,无法直接吞吐几十个 GB 的原始传感器读数或高维矩阵。我们需要另一位人类学者先帮我们做一次高压缩率的信息蒸馏,把发现写成摘要、图表和结论,再用自然语言讲清楚。
但当科研的主体里加入了模型和 Agent,这套介质的优先级被倒转了。
对模型来说,排版精美的双栏 PDF 反而是最难啃的“非结构化噪声”——它需要复杂的 OCR 拆解版面、还原跨页表格、猜出图注里的变量含义,最后得到的还只是作者筛选后的二手结论。相反,带有清晰 Schema(数据结构定义)、标准元数据、可编程接口和完整血缘记录的标准化数据集,才是它能直接吸收、跨模态对齐甚至用来推演新规律的“第一手燃料”。
WorldParticle 之所以能用单一模型模拟从沙粒滑动到蛋白质折叠的六类物理系统,前提不是物理学家在代码里写死了六套方程,而是系统能直接吞入标准化后的粒子轨迹数据;[2]SLAC 国家加速器实验室之所以能把自由电子激光的脉冲模拟提速 250 倍,靠的也是神经网络直接拟合传统分步傅里叶模拟生成的海量晶体转换数据。[3]
当研究范式从“人写公式、机器算数值”转向“机器从数据中归纳动力学”,数据的地位就从“论文的附录”变成了“基础设施本身”。
二、协议层上的“去界面化”:从麦格劳希尔到 Project ProtoStar
我在写麦格劳希尔接入 MCP 那篇文章时提到过一个判断:当知识检索和推理的入口被通用 Agent 接管后,传统知识机构如果还执着于把内容锁在自己的封闭网页或阅读器里,就会变成互联网上的信息孤岛。它们唯一的出路,是把自己降维成底层的“授权数据源”,通过标准协议把原子化的知识颗粒喂给上层的模型。
Project ProtoStar 在科研领域做的,其实是同一件事的公共版本。
过去,很多政府资助的科研项目虽然在结题报告里写明了“数据公开”,但实际执行往往停留在“把一堆格式混乱的 CSV 和说明文档打包上传到某个大学 FTP 服务器”。人类研究者要复用这些数据,往往需要花几周时间写脚本、对齐单位、处理缺失值——这种高昂的清洗成本,把绝大多数跨学科复用挡在了门外。
Project ProtoStar 试图建立的,正是公共科研产出的 AI-Ready 制度标准。它解决的不是“有没有公开”,而是“机器能不能直接用”:统一格式规范、补全机器可读的描述字段、接入可直接评测和调用的社区管线(比如联合 CMU 发起的气候风险智能挑战赛)。[1]
把这两条线并在一起,我们会看到一条清晰的演进路径:
| 维度 | 传统知识分发模式 | AI 时代基础设施模式 |
|---|---|---|
| 核心交互对象 | 人类读者(学生、审稿人、同行) | 模型训练管线、科研 Agent、推理引擎 |
| 标准交付形态 | 排版 PDF、封闭电子书、静态网页 | 标准化数据集、结构化知识库、MCP/API 接口 |
| 质量瓶颈 | 论证逻辑、文字表达、版式规范 | Schema 一致性、元数据完整性、可验证血缘 |
| 复用方式 | 人工阅读、摘要引用、手工重录 | 自动化采样、跨领域对齐、端到端微调与推演 |
在工程领域,我们早就习惯了“API 优先(API-First)”的设计原则——先定义好机器之间交换数据的契约,再去考虑给人看的界面。如今,这股浪潮正在向人类最古老、最厚重的两个知识部门蔓延:教材出版与基础科学研究。
三、真正的难点不在存储,而在“信用”与“噪声治理”
不过,一年暴增 3.9 倍的数据集数量,并不自动等于科学发现的加速。
如果仔细看 Hugging Face 披露的细节,里面有一个很值得玩味的数字:在 2026 年新增的 21,000 个科学数据集中,仅单一最大上传者就贡献了 3,021 个数据集。[1]
这暴露了一个伴随“AI-Ready 化”而来的新问题:当上传数据集的门槛降到和建一个代码仓库一样低时,科学语料库同样会面临“灌水”与“噪声污染”的挑战。
在传统的期刊体系里,虽然审稿周期漫长、版面费高昂,但它至少建立了一套运转了数百年的学术信用与责任追溯机制。一篇论文发出来,谁是第一作者、谁是通讯作者、哪个机构背书、实验数据出了问题找谁撤稿,权责是清清楚楚的。
但在海量自动化抓取、脚本批量转换、模型合成数据混杂的开源数据集生态里,新的治理问题正在浮出水面:
- 谁来为数据集的“清洗保真度”负责? 把一份原始观测记录转换成 AI-Ready 格式的过程中,插值算法的选择、异常值的剔除、单位的归一化,本身就隐含着科学判断。如果转换脚本有隐蔽的 Bug,下游成百上千个调用该数据集的科研 Agent 就会在不知情的情况下集体跑偏。
- 学术评价体系如何承认“修路工”? 在现有的高校职称与基金评审里,发一篇顶刊论文的权重远远高于维护一个高质量公共数据集。如果只靠开源社区的情怀和零星的挑战赛,公共科研数据的长期维护很快就会遇到激励枯竭。
- 验证成本从论文转向了数据管线。 过去审稿人核查的是论文里的论证与图表;当 AI 可以批量爬取、转换并格式化成千上万个数据集时,稀缺的不再是“可用格式的数据量”,而是可追溯、可复现的数据血缘链条——这份数据究竟来自真实的物理传感器,还是某个大模型在上一轮生成中留下的合成残留?
四、写在最后:重塑“书写”的边界
“仓颉造字”的隐喻,指向的是人类用符号封装经验、跨越时空传递认知的能力。
在很长一段时间里,我们默认这种封装的终极形态就是“文章”与“书籍”——把复杂的世界压缩成线性的文字,等待另一个大脑来解码。
但今天,当我们在谈论“知识生产”时,我们的读者名单里已经永久性地多出了一类非人智能。它们不欣赏修辞,不在乎双栏排版的视觉美感,它们需要的是干净的边界、明确的类型、可追溯的来源,以及能直接接入工作流的结构化接口。
这并不意味着给人看的深度写作会消失——恰恰相反,在机器接管了海量数据的吞吐与初级模式归纳之后,人类更需要通过高质量的写作去提出真问题、界定概念边界、做出价值判断。
只是在知识生产的底层地基上,一场静悄悄的改建已经开始了:最好的实验室和出版社,正在学会同时用两种语言工作——一种写给人看,另一种,写给 Agent 调用。
资料来源
[1] Hugging Face. Announcing Project ProtoStar: Making Publicly Funded Science AI-Ready,2026 年 10 月 29 日。
[2] MIT CSAIL, UBC 等团队. WorldParticle: Unified World Simulation of Lagrangian Particle Dynamics via Transformer,arXiv:2605.15305。
[3] SLAC / Stanford / UCLA. 基于 LSTM 代理模型的 LCLS-II 光阴极驱动激光非线性晶体转换模拟(Split-Step Fourier Method 数值模拟训练数据,提速超 250 倍)。
[4] McGraw Hill. McGraw Hill Announces Agentic AI Education Plugin for Microsoft Copilot,2026 年 10 月 29 日。
AI 贡献声明
AI 参与了文章所涉公开资料的检索核验、局部事实表述修正与视觉概念配图生成;选题判断、核心论证结构、观点取舍与最终定稿由作者完成。