OpenAI 又攻克数学难题!研究背后可能是另一种 Scaling Law?
一次数学研究背后的大量并行探索,如何改变我们对 AI 完成复杂任务的期待。
前几天,看到 OpenAI 宣布攻克纳维–斯托克斯方程重大问题的新闻,我仿佛一下子被拉回了本科的流体力学课,也因此有了深入了解这则消息的念头。
顺着报道往下看,我开始留意到,除了“攻克数学难题”这个结果,AI 在背后如何参与研究,以及伴随的争议,也挺有意思。[1][2]
一、关于这则消息
纳维–斯托克斯存在性与光滑性问题是七个千禧年大奖难题之一。OpenAI 称,其内部模型给出了光滑外力作用下,流体在有限时间内形成奇点的证明,并公开了论文和 Lean 形式化文件。[1]
消息也伴随着争议。数学家 Tristan Buckmaster 与 Levent Alpöge 此前已在相关欧拉方程问题上取得进展。这场争议颇有一点 AI 时代的特点:除了研究路线和署名,Buckmaster 还提出了数据使用方面的质疑——研究者此前与 ChatGPT 的对话,是否可能影响模型后来的结果。
Buckmaster 也明确表示,他并不知道自己的数据是否真的被使用。OpenAI 则否认在对方公开前看过他们的工作,同时承认他们在受迫欧拉问题上的优先权。[1][2]
这些争议暂且放在一边,我们先看看这项研究是怎么做出来的。
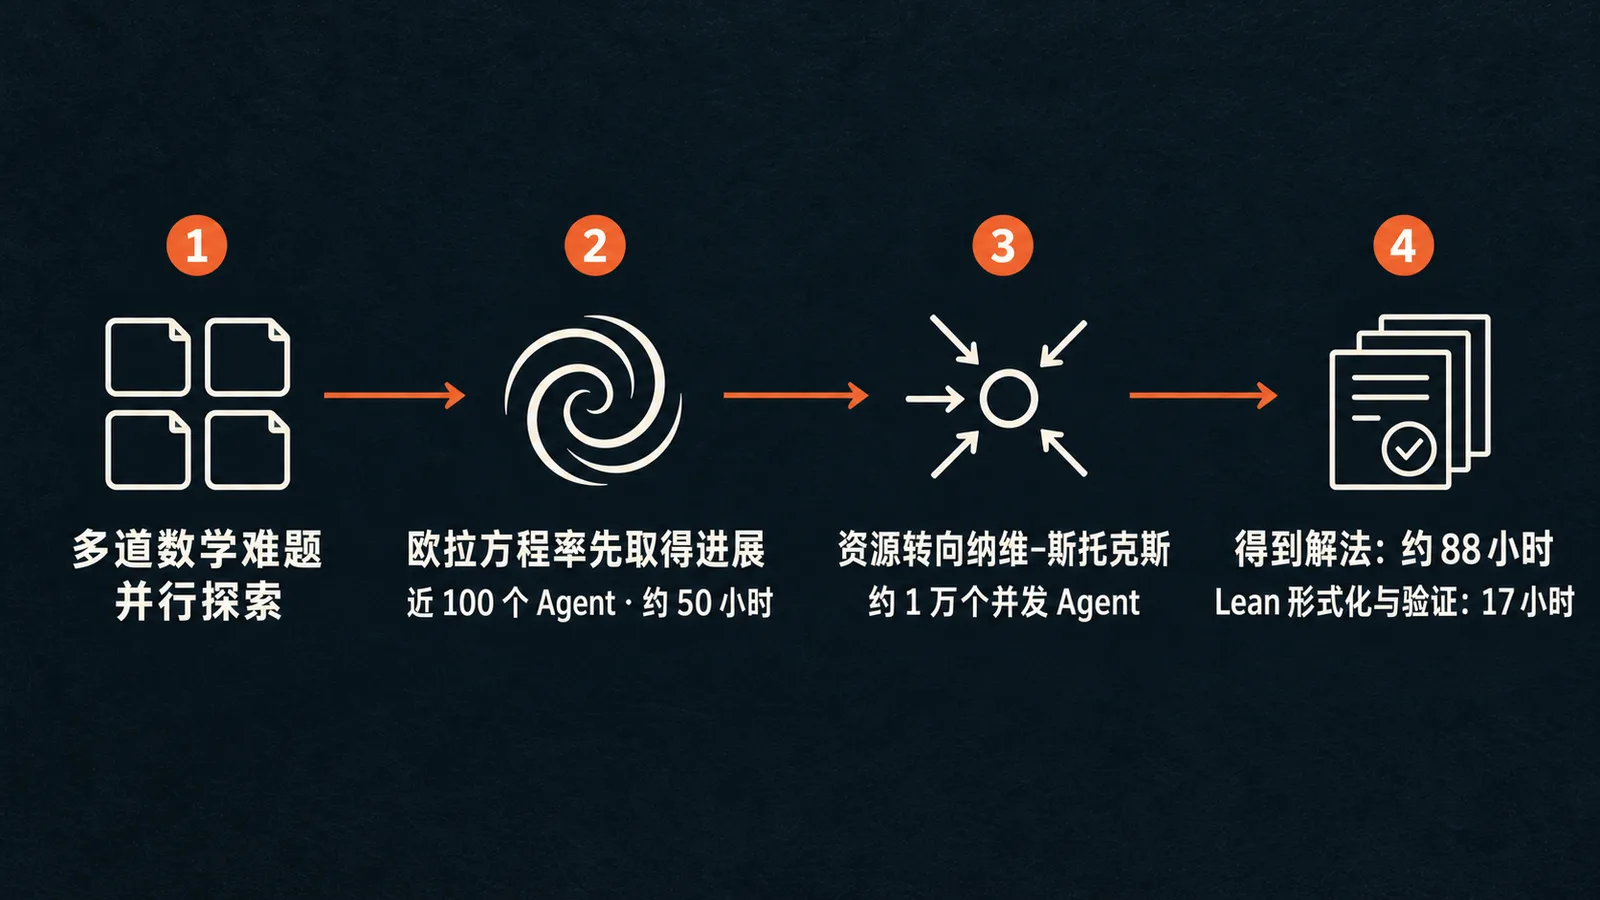
OpenAI 的研究团队起初并没有只盯着纳维–斯托克斯问题。根据官方说明,团队让不同的 Agent 小组探索所有尚未解决的千禧年难题,以及另外几个重要的数学问题;同一道题的不同版本,也交给不同小组尝试。这些 Agent 能读取资料、运行代码,还能与同组成员交换信息。
关键进展最先出现在与纳维–斯托克斯密切相关的欧拉方程方向。近 100 个 Agent 合作约 50 小时,得到无外力情形下的结果。团队因此认为纳维–斯托克斯方向最有希望,于是把其他难题上的 Agent 调过来,并将已有的欧拉结果交给它们继续研究。
此后,不同小组继续探索不同路线。团队还借助 Codex 汇总各组有用的中间结果,将这些进展写进后续提示。最终找到解法的那一组,规模约为一万个并发 Agent。从首批 Agent 启动到得到结果,约用了 88 小时,之后又用了 17 小时完成 Lean 形式化与验证。[1]
二、研究背后的另一种 Scaling Law
我们平时提到 Scaling Law,通常是说,随着模型、训练数据和计算量不断增加,模型的表现往往也会变得更好,而且这种变化大致有规律可循。[3]
而前面提到的一万个 Agent,很像另一种 scaling:把更多 Agent、更多尝试和更多探索路线投入同一个问题。
OpenAI 的开发者和研究者,可以算是世界上最会用 AI 的一群人。他们没有把希望押在某一个 Agent、某一次执行上,而是让 Agent 分头探索,根据中间结果调整投入,再把有用的线索带进下一轮工作。他们投入大量 Agent 和计算资源,换来更多次探索、筛选和纠偏的机会,直到找到一条可行的路。
这和我们日常使用 AI 的方式,以及对 AI 的期待,似乎大相径庭。
大多数时候,我们只提供有限的提示词,却希望 AI 在一次或少数几次尝试中,把一个连我们自己都很难说清“怎样才算好”的任务做好。至于中间可能经历的探索、碰壁和重来,我们往往没有多少耐心。
玩过 AI 生成图片或视频的朋友,可能都有过“痛苦的心得”:同一个提示词,第一张构图不错,人物表情却不对;第二张表情对了,细节又跑了。没办法,只好耐下性子改几个词,再抽一张。这样来回生成几轮,再从结果里挑挑拣拣,才可能选出一张满意的。
我们个人使用的时候,当然不可能像 OpenAI 一样,调动一万个 Agent 围攻一个问题。但遇到复杂任务时,可以先让 AI 多试几个方向,从中挑出值得继续的,再一轮轮往下做。
三、很多事情,本来就是慢慢做出来的
一篇文章交出去之前,可能换过几次开头,删掉过整段论述;一个方案定下来之前,也可能经过好几轮讨论和修改。我们自己做事时,也是一边做,一边改。
使用 AI 处理复杂任务时,也可以这样往下做。回答不合适,就接着追问;方向走偏了,可以退回来重做。几种方案各有问题,也可以放在一起比较,再决定往哪边走。
最后交到我们手里的结果,该准确的要准确,该完整的要完整。只是在那之前,多试几次、多改几轮,甚至推倒重来,都很正常。
我们可以要求 AI 把事情做好,只是不必要求它一次就做好。
资料来源:
[1] OpenAI:On the Navier–Stokes Millennium Prize Problem,2026年9月8日。
[2] Tristan Buckmaster 公开声明,2026年9月9日访问。
[3] Scaling Laws for Neural Language Models,Jared Kaplan 等,2020年。