爆火的 Jev,我们拿 1711 道高考题测试了它
一个不生成文本、只负责判断的模型,在 1,711 道高考客观题上答对了 90.8%;读完 17 篇作文后,它又显示出成为第二判断来源的可能。
2026 年 9 月 15 日,TypeSafe AI 发布 Jev,把它称为首个 System One Model。[1]
在 TypeSafe 的官方发布文章中,Jev 有三个特点最值得注意。[1][2]
第一,Jev 的输入是非结构化状态,输出是带有类型和概率的判断。
unstructured state in, typed probabilistic decisions out
和我们熟悉的大语言模型不同,Jev 可以处理文本等非结构化输入,但不是文本生成模型。它只负责作出判断:判断一件事是否成立,从若干个选项中选出一个,或者按照预先设定的等级评分。
第二,Jev 不会返回预设类型之外的结果。TypeSafe 因此称它“不会产生幻觉”。[1]
Jev gives up string generation, it’s optimized for structured outputs and can’t hallucinate.
不过,这里的“不产生幻觉”不是说 Jev 的判断不会出错,而是说问题和可能的答案事先定义,它只能从预设类型中返回结果。
第三,Jev 很快。
40x-200x faster
TypeSafe 称,Jev 在 System One 类型的任务上可以达到与现有大语言模型相近的智能水平。官方给出的端到端延迟是 70—500 毫秒,同类任务下可能比现有模型快 40—200 倍。Jev 使用了新的模型架构和并行采样器:大语言模型逐个生成 token,Jev 则并行给出各项判断的概率和置信度。[1]
这让我们产生了一个技术上的猜测:Jev 是不是以更小的模型规模和更窄的能力范围,换来了这样的效率?
我们真正好奇的是:Jev 的知识覆盖究竟有多广,能不能支撑它在不同领域里都快速、准确地作出判断?
要回答这个问题,我们或许需要一组知识跨度足够大、答案又相对明确的测试题。首先想到的就是高考题。
01 1711 道高考客观题,答对了 1553 道
题目来自 GAOKAO-Bench 和 GAOKAO-Bench-Updates 两个公开数据集,覆盖 2010 至 2024 年的语文、数学、英语、物理、化学、生物、历史和政治试题。[3][4]
我们从中整理出 1,711 道单选题,并采用零样本方式测试。我们把每道题的科目、题干和四个选项单独交给 Jev,让它直接从 A、B、C、D 中选出答案。
结果比我们预期的高。
Jev 一共答对 1,553 道,总体正确率为 90.8%。
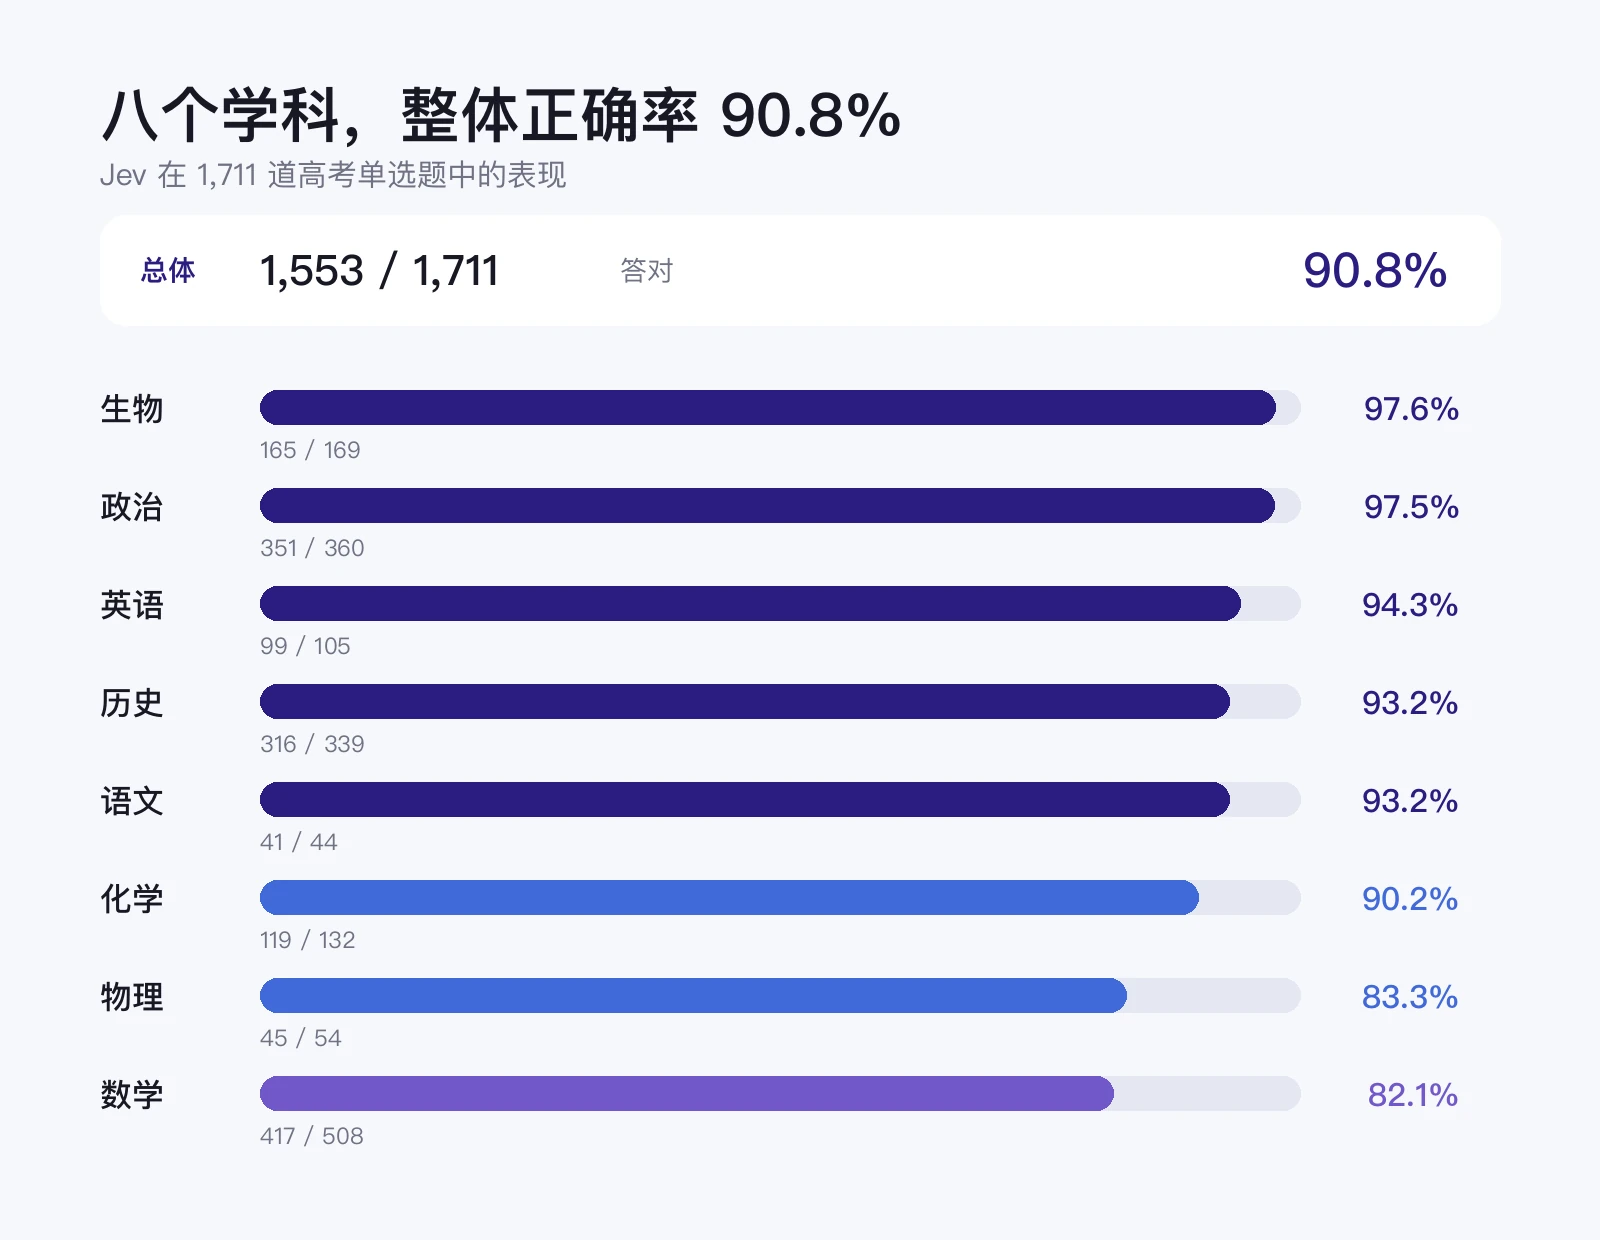
生物和政治都接近 98%,英语、历史和语文也超过 93%。相对较弱的是物理和数学。
Jev 的输出还包含每个选项的概率。我们取每道题中概率最高的一项,并按照这个概率对所有题目分层。结果显示,最高概率越高,对应题目的实际正确率也越高。
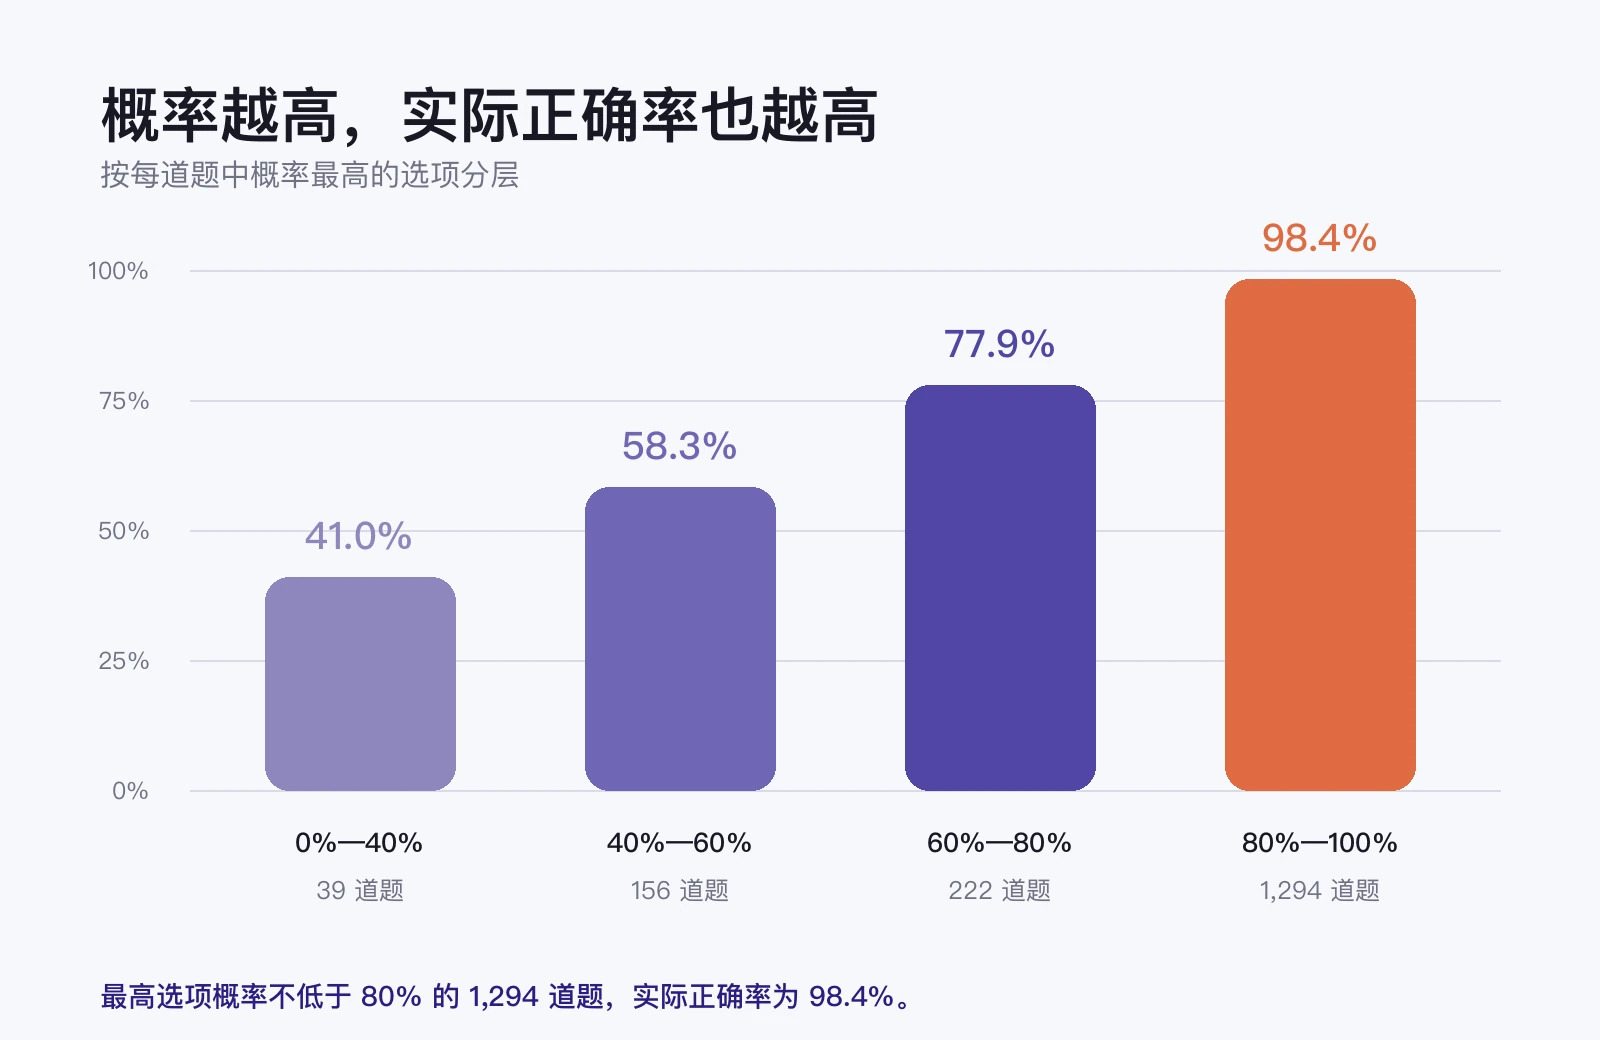
其中,最高选项概率不低于 80% 的 1,294 道题,实际正确率达到 98.4%。这说明 Jev 输出的概率与实际正确率之间具有明显的对应关系,可以反映不同判断的可靠程度。
02 做完选择题,我们又让 Jev 读了 17 篇作文
通过前面的客观题测试,我们看到,Jev 虽然不是文本生成模型,但仍然具备相当不错的通识能力。我们接着想把问题往前推一步:面对没有唯一答案、需要综合评价的任务,它会怎么判断?作文评分本来就有档位之分。如果先给模型明确的档位标准,再让它从几个有次序的等级里做判断,这件事在形式上仍然属于 Jev 擅长的评分或选择任务。
我们找来 17 篇作文,把作文命题、档位标准和正文交给 Jev,让它直接判断每篇作文属于哪一个粗档。其中包括 4 篇上海高考阅卷教师培训样文和 13 篇 2025 年海淀高三二模作文,两组材料都附有公开的分数和档次。[5][6] 对照这些公开结果,Jev 有 11 篇与原有档次一致,6 篇存在分歧。
我们重新读了全部 6 篇分歧作文,并按照自己的理解重新判断。其中 2 篇,我们更认同 Jev 的档次;另外 4 篇,我们更认同原有的档次。按照我们的复核判断,Jev 在 17 篇作文中有 13 篇判断正确。
这也说明,Jev 与原有档次不一致,并不总意味着它判断错了。有时候,这种分歧正好说明这篇作文值得再读一遍。
03 所以,Jev 到底能干什么
Jev 这种新的模型形态,也给了我们一些关于应用场景的启发。放到考试里,它可以在原有评分之外,再提供一个可供对照的独立判断。
考试只是一个容易理解的例子。现实中,还有很多工作也是先给出标准,再对复杂信息作出选择、评分或复核,Jev 或许也会在那里派上用场。
资料来源:
[1] TypeSafe AI:Introducing System One Models & Jev,2026 年 9 月 15 日。
[2] Cloudflare AI Docs:Jev(typesafe)。
[4] OpenLMLab:GAOKAO-Bench-Updates。
[5] 华东师范大学:《新闻晚报》:高考作文评级标准这样“炼”成。
AI 贡献声明
本文由作者提出测试问题、整理题目、运行评测、复核作文分歧并作出最终判断;ChatGPT 网页版与 Codex 参与资料整理、结构讨论、文字修改和数据图制作。作者负责事实核验、观点取舍与最终定稿。